篱笆资讯
语音 Agent 说完不等于做完:理解 Gemini Live 的分工与任务状态
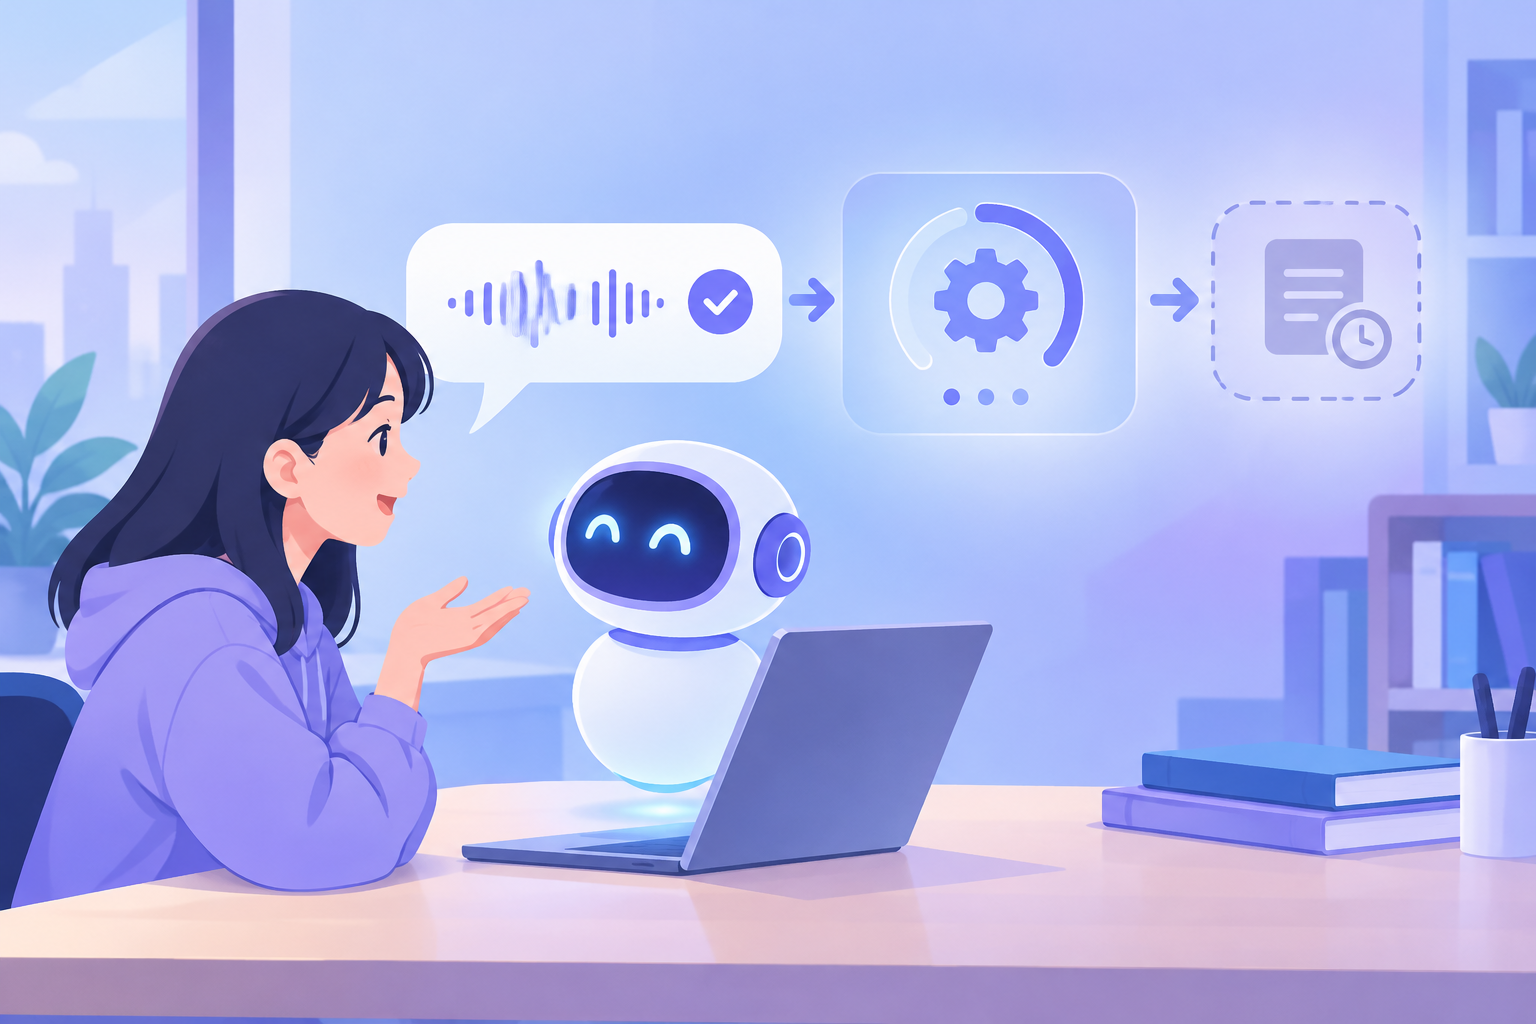
从 Gemini Live 发布报道看语音 Agent 的任务边界
模型说了一句“我来查一下”,随后停止播放语音。客户端能否撤掉等待提示,让用户认为任务已经完成?
仅凭语音播放结束,不能做出这个判断。 播放器知道一段音频播完了,却未必知道后台工具是否返回、结果是否有效,以及这次请求是否还在执行。
Gemini 3.8 Live 与 Extended Thinking 的发布报道,为理解这一区别提供了一个切入口。下文按报道所述定位展开,区分产品描述与工程建议;具体能力、接口字段和状态转换,仍需核对实际接入版本的官方文档。
一、两类模型的区别,不是能不能调用工具
按报道的描述,Gemini 3.8 Live 侧重低延迟和规模化部署,Extended Thinking 则面向需要多步推理、多个工具参与的复杂任务。后者可以在后台继续处理任务,同时先回应用户、播报进度,最后返回结果。
需要特别澄清:报道所述的两类模型都支持异步工具调用。 因此,不能把它们理解成“基础版只能聊天,另一款才能使用工具”。
更有用的区分方式,是看应用需要解决哪一种等待:
| 需求维度 | 要回答的问题 | 按报道定位可优先考察的方向 |
|---|---|---|
| 即时交互 | 用户说完后,系统能否及时接话? | 侧重低延迟交互的模型 |
| 复杂执行 | 系统能否组织多个步骤,并处理工具返回? | 侧重后台多步任务的模型 |
这里有两个不同的计时终点:从用户说完到系统开始回应,以及从发起请求到得到可用结果。“我来查一下”可以让第一段等待更短,但不代表第二段等待也缩短了。
这只是选型维度,不是性能结论。现有材料不足以证明哪款模型在你的工具链里更快、更便宜或成功率更高。
二、把一次请求拆成两条流程
二、把一次请求拆成两条流程
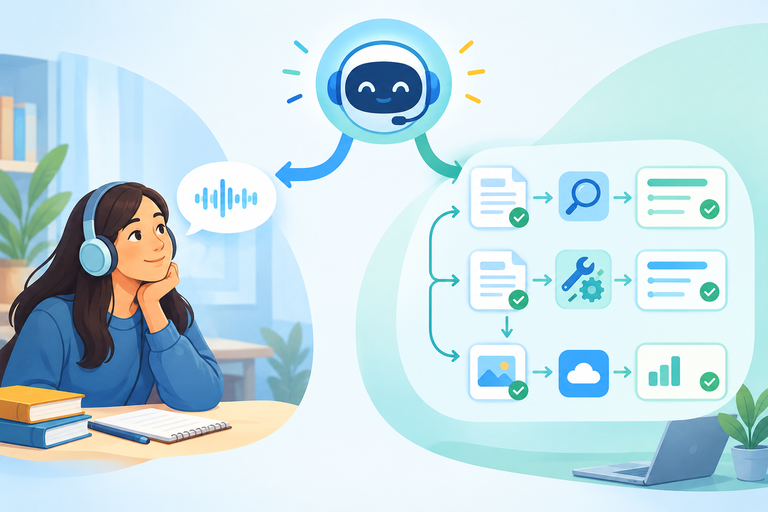
假设你在开发一个语音技术助手,用户要求它查阅两份接口说明,再解释配置差异。下面是教学用的流程拆解,不代表某个 API 的真实事件顺序,也不是实测案例。
交互流程: 用户提出问题 → 系统确认收到 → 必要时播报进度 → 播放最终答案。
任务流程: 确定查询步骤 → 调用工具 → 等待并处理返回 → 检查是否满足请求 → 生成结果。
两条流程会相互配合,但不必同步结束:
| 阶段 | 用户可能听到什么 | 后台可能在做什么 | 客户端应如何理解 |
|---|---|---|---|
| 确认请求 | “我来查一下” | 准备查询或发起工具调用 | 已接收,不等于已完成 |
| 等待返回 | 暂时没有声音 | 等待外部服务 | 安静不代表空闲 |
| 进度播报 | “还有一份说明需要核对” | 继续查询或处理结果 | 进度信息,不是最终答案 |
| 返回结果 | 配置差异说明 | 输出可用结果 | 再按应用完成条件确认结束 |
如果第二次查询依赖第一次返回的数据,任务就需要继续推进。即使最后一句进度提示已经播完,也不能据此关闭等待界面。
这个区分并不只适用于 Extended Thinking。只要应用涉及异步工作,就应分别处理“音频结束”和“任务结束”,而不是让播放器事件代替业务判断。
三、怎样理解 IN_PROGRESS、IDLE,才不会误接接口
报道提到,开发者应关注 Live API 返回的 `IN_PROGRESS` 和 `IDLE` 状态,而非仅根据一段语音是否结束判断任务进展。
但这些名称在本文中仅指报道所述状态。现有材料不足以确定它们对应的准确字段、事件结构、适用版本,以及转换发生的具体条件。尤其不能只凭 `IDLE` 的字面含义,就断言“用户要求已经成功完成”。
接入时,建议先落实四件事:
- 核对状态的作用范围。 它描述的是模型活动、一次响应、整个会话,还是应用任务?不同范围不能直接互换。
- 定义业务上的完成条件。 例如必要查询已经返回、结果通过基本检查、答案可以交付。工具有返回,也可能返回错误或不完整数据。
- 让播放与执行状态分开。 “正在说话”和“仍在处理”可以同时存在,也可以分别结束。音频播放完毕只更新播放状态。
- 单独处理失败、取消和超时。 不要把所有不再运行的情况都显示为“已完成”。发生超时后,也不能在未确认取消效果时,假定外部工具已经停止。
应用内部可以设计“等待工具”“结果可用”“失败”等业务状态,但应明确:这些是你自己的状态设计,不是本文确认的 Live API 枚举。
进度文案也要与可确认的信息一致。如果系统只知道请求仍在处理,就不要展示“已经完成大部分查询”之类缺乏依据的进度。
四、选型时先测试任务,不要先给模型排名
对于正在学习实时语音交互、制作 AI Agent 项目的开发者,可以先用三个问题缩小测试范围。
第一,用户最不能接受哪种等待? 如果应用主要是短问短答,先测试接话速度、打断处理和连续对话体验。若请求通常需要查询多个来源,则还要观察完整任务耗时和结果是否可用。
第二,工具之间有没有依赖? 一次独立查询与“先获取信息,再据此决定下一步”是不同的工作流。先画出依赖关系,才能判断是否需要重点评估多步任务能力。工具数量本身不是唯一标准。
第三,失败后能否安全恢复? 查询失败可能允许重试;涉及修改数据的操作,则应先确认是否已执行,避免重复提交。不要把所有工具调用都视为同一种风险。
测试时,让两类模型面对相同请求、相同工具和相同结果检查条件。至少分别记录:
- 用户说完到首次回应的时间;
- 请求开始到结果可用的时间;
- 工具错误后的处理表现;
- 进度提示是否与实际执行情况一致。
再加入几种边界情况:工具长时间不返回、某一步失败、用户中途打断,以及旧请求的结果晚于新请求到达。观察客户端会不会提前宣布成功,或把旧结果交给新任务。
如果用于 Software Engineer 或 AI Engineer 的项目展示,可以保留一段演示:进度语音已经播完,界面仍显示处理中,直到结果满足完成条件才结束等待。配合任务流程图和测试记录,这能清楚说明你如何区分对话体验、工具执行与业务结果,而不只是接通了一个语音模型。


 直连行业大牛导师,1v1模拟面试与求职指导
 实战与求职精品课程
 2000+名企面试真题