篱笆资讯
扩散模型 4 位量化:平滑为何不够,内核融合解决什么?
从 SVDQuant 到 Nunchaku:看懂扩散模型 4 位量化的两道关
周报对 Nunchux 技术路线的介绍,把 SVDQuant 和 Nunchaku 放在了一起。这个切入点值得生成式 AI 开发者关注:模型压缩与推理执行,解决的是不同问题。
把权重和激活降到 4 位,首先要处理数值误差;增加补偿分支之后,还要检查执行成本。低位宽计算节省的时间,可能被额外的数据搬运抵消。
读懂扩散模型量化方案,需要分别回答:量化后的结果能否接受,实际执行路径是否更省时。 以下沿着原始项目介绍拆解机制,不据此推断产品性能或世界模型适用性。
一、平滑能迁移离群值,却不保证两边都容易量化
理解 SVDQuant 原理,可以先从离群值入手。某些通道中幅度特别大的数值,会拉大量化需要覆盖的范围。量化刻度有限时,其他数值的表示精度就可能受到影响。
大语言模型中常见的平滑思路,是调整激活与权重的通道尺度。在保持原始矩阵乘法结果等价的前提下,把激活侧的一部分量化难度转移到权重侧。
这解释了平滑的作用,也说明了它的边界:难度被重新分配,不代表难度消失。
SVDQuant 原始项目介绍指出,在其扩散模型的 4 位权重与激活量化设定下,两者都对量化高度敏感,单靠大语言模型中常用的平滑方法已经不够。激活更容易量化后,接收了离群值的权重仍可能成为误差来源。
这个结论有明确范围,不能扩写成“大语言模型量化方法对扩散模型全部失效”。它讨论的是特定低位宽设定下,平滑不足以独立完成任务。
阅读其他部署方案时,也应先问清楚“4 位”修饰什么:只有权重,还是权重与激活?是否保留部分高精度计算?仅凭一个位宽标签,无法判断数值难度和实际执行成本。
二、低秩分支处理误差,内核融合处理额外搬运
二、低秩分支处理误差,内核融合处理额外搬运
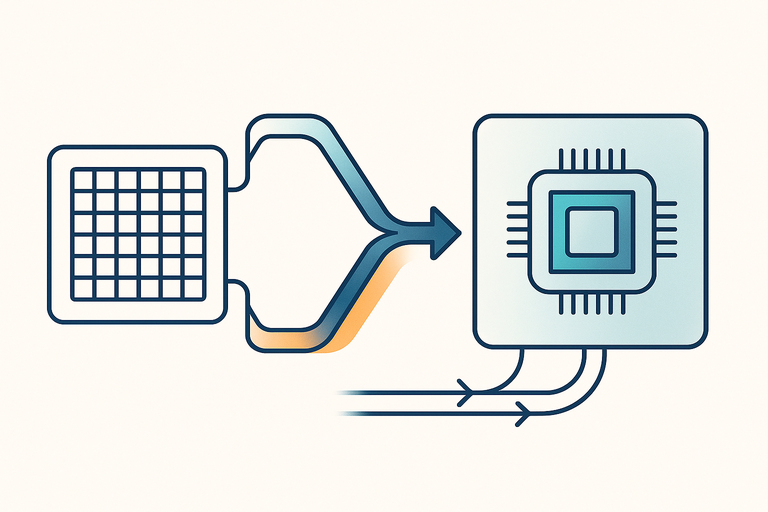
SVDQuant 在迁移离群值之后,又增加了一步:利用奇异值分解(SVD),让高精度低秩分支吸收权重中的离群值,剩余部分交给低位宽分支处理。
可以把它理解为两条协作的计算路径:
- 高精度低秩分支承接难以直接低位量化的成分。
- 低位宽分支处理剩余部分,承担主要的低位宽计算。
这是一种混合精度安排,并不意味着模型中的所有运算都变成了 4 位。低秩分支也不宜理解成“找到几个异常元素并删除”,它通过分解得到的低秩表示承接相关成分。
数值问题缓解后,执行问题随之出现。同一项目说明,如果把低秩分支独立运行,额外的激活数据搬运会引入明显开销,可能抵消量化带来的加速收益。
“低秩”只说明分支的结构特点,并不意味着它在系统中没有成本。即使新增计算不多,激活仍需要被读取、传递和消费。判断代价时,不能只数矩阵乘法的运算量。
Nunchaku 内核融合针对的正是这一环节:把低秩分支的内核融合进低位宽分支的内核,减少冗余显存访问。
这里应分清两个因果关系:
高精度低秩分支服务于数值误差处理,内核融合服务于执行效率。 两者需要配合,但不能相互替代。也不能只凭“做了融合”,就推断具体显存布局,或断言整条生成流程一定获得相同比例的加速。
部署评估仍需回到实际模型、输入形状和硬件条件,分别测量模块耗时与端到端延迟。
三、视频还多了一层变化:去噪步骤之间,激活并不静止
图像模型上的量化思路,也不能未经检查就原样搬到视频模型。
DeltaQuant 原始项目介绍强调,视频扩散模型的激活具有明显的动态性:随着去噪时间步变化,离群通道及其幅度可能显著改变。这是该项目针对已有方法提出的观察,不应直接概括为所有视频模型上的统一结论。
它带来的实际问题是:在某些时间步观察到的数值范围,是否足以代表其他时间步?一种静态处理方式,能否覆盖整个去噪过程?
DeltaQuant 利用局部时空结构处理这一问题。它将激活划分为局部三维时空块,以每个块的平均 token 作为核心 token,保留为 FP8;相对核心 token 的较小差分,则量化为 4 位。
这里的关键是“核心加差分”的表示方式,不能简化成“视频激活全部降到 4 位”。核心 token 与差分 token 使用不同精度,评估时也应分别看待它们的成本。
这个案例提示开发者,视频扩散模型量化除了检查离群值大小,还要观察它们随时间步如何变化,以及局部时空结构能否被利用。本文将 DeltaQuant 作为独立研究案例,现有材料不足以确认它已集成到 Nunchux。
四、读部署方案时,用四个问题决定下一步实验
对学习模型部署的学生,以及准备美国 AI 推理系统相关岗位的开发者,更有价值的准备,是把上述区别转化为可验证的问题。
| 检查项 | 应追问什么 | 实验中记录什么 |
|---|---|---|
| 离群值 | 出现在哪些层、哪些通道?迁移后难度去了哪里? | 激活与权重的范围、分布及量化误差 |
| 混合精度分支 | 哪部分保留高精度?低秩分支承担什么? | 各分支精度、秩设置与生成质量变化 |
| 数据搬运 | 分支独立执行时,有哪些额外激活读写? | 内核耗时、显存访问与端到端延迟 |
| 激活动态性 | 不同去噪步骤是否呈现不同分布? | 跨时间步统计,以及视频时间一致性表现 |
若要做小型复现实验,可以先固定模型、硬件、输入尺寸和去噪设置,建立高精度基线。再分别比较量化后的质量、独立分支的开销,以及融合实现的表现。不要在改变多个条件后,只用一个总耗时解释原因。
面向 ML Systems Engineer、Inference Engineer 等方向的技术讨论,这类实验可以帮助你讲清楚:误差从哪里来,补偿分支为什么存在,节省的计算又是否被搬运成本吃掉。这是技术准备建议,不代表任何企业当前的招聘要求。
下一次看到“4 位部署”时,先找出它的精度边界和执行路径。只有这两张图都清楚了,位宽数字才有可比较的意义。


 直连行业大牛导师,1v1模拟面试与求职指导
 实战与求职精品课程
 2000+名企面试真题