篱笆资讯
Azure AI Search 选型:关键词、向量与语义重排如何组合
Azure AI Search 检索怎么选:先看召回,再看排序
搭建企业搜索或 RAG 系统时,关键词检索、向量检索和语义重排经常出现在同一张架构图里。但功能齐全,不代表每一层都值得开启。
更有效的选型起点是:正确内容根本没有进入候选集,还是已经进入候选集,却排不到前面?
前者需要检查召回路径,后者需要检查融合、排序和截断。Azure AI Search 的混合检索可以组合关键词与向量召回,语义重排则是可选的后续步骤。是否组合,应由实际查询表现决定。
一、先确认问题发生在哪一层
假设企业知识库里确实存在正确答案,搜索结果却没有把它交给用户。不要立即更换 embedding 模型,先沿检索链路检查:
- 内容是否可检索? 检查文档是否入库、字段是否正确配置、切块是否保留了答案,以及过滤条件是否排除了目标内容。
- 各路召回是否找到目标? 分别查看关键词和向量检索的候选结果。两路都没有命中,才需要重点排查召回。
- 目标在哪一步掉出结果? 如果原始候选里有目标,但融合后的前列结果没有,应检查融合排序及后续截断;如果进入重排后仍靠后,再评估重排效果。
在 RAG 中,还要区分“检索没有给出证据”和“生成模型没有正确使用证据”。如果送入模型的上下文已经包含完整答案,继续增加检索层未必能解决问题。
这里的关键是保留中间结果。只看最终回答好不好,无法判断该调整索引、召回、排序,还是生成提示。
二、理解链路:两路召回、RRF 融合、可选重排
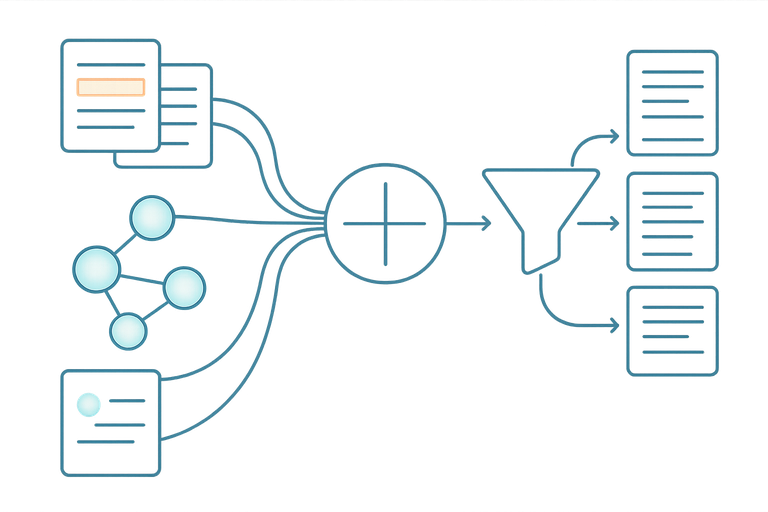
二、理解链路:两路召回、RRF 融合、可选重排
关键词检索与向量检索的区别,首先体现在它们依据什么寻找内容。
关键词检索依赖文本匹配,全文结果可使用 BM25 排序。微软将产品码、专业术语、日期和人名列为可能更适合关键词检索的场景。查询中的具体词项本身就有辨识力,保留这条路径通常值得考虑。
向量检索通过向量相似性寻找概念接近的内容,即使查询和文档没有相同关键词,也可能建立联系。例如,用户问“如何撤销团队成员的访问权限”,文档标题可能是“员工离职账号处理流程”。这类措辞差异,是评估向量召回价值的合理起点。
根据微软的混合检索说明,Azure AI Search 可以同时执行全文与向量查询,再使用 RRF(Reciprocal Rank Fusion,倒数排名融合)合并结果。可以把它理解为依据各路结果中的排名形成统一排序,而非直接相加 BM25 分数与向量相似度。
链路可以简化为:
`关键词召回 + 向量召回 → RRF 融合 → 可选语义重排 → 返回结果`
Azure semantic ranker 是后续重排层,不是向量检索的别名。 在混合检索中,它位于 RRF 之后,对已有候选中的适用文本内容重新排序。它也能用于全文检索结果,因此“关键词检索加语义重排”同样是可评估的方案,不必先加入向量检索。
微软的混合检索排序文档明确区分了 RRF 融合和 semantic ranking。就这一步骤而言,重排处理的是已有候选,无法替代缺失的召回路径。
三、三类需求,决定组合是否值得测试
以下是选型起点,不是固定配方。
| 查询需求 | 先检查什么 | 值得评估的路径 |
|---|---|---|
| 产品码、广告 ID、错误码等精确标识符 | 标识符是否完整保留,字段和查询配置是否适合匹配 | 先建立关键词或精确字段查询基线;同时存在描述性查询时,再测试混合检索 |
| 同一概念有多种说法 | 关键词查询是否漏掉相关表达,向量候选是否真正相关 | 对比关键词、向量与混合检索 |
| 正确内容已召回,但位置靠后 | 候选文本是否充分,相关结果在哪一步被挤出 | 对比融合结果与增加语义重排后的结果 |
精确标识符场景尤其容易被误判。关键词检索值得保留,不等于任意全文字段都能保证完整 ID 匹配。分词方式、字段配置和查询写法都需要验证;如果业务要求严格相等,应单独设计和测试精确字段查询或过滤路径。
一篇论坛讨论的作者自述,其团队早期使用纯向量检索时,遇到过精确广告 ID 搜不到的问题。这是未经独立核验的个案,只能作为设计测试查询的提醒,不能据此推导纯向量方案普遍失效,更不能证明某个产品性能更好。
概念查询也有另一面:向量可能找回“主题相近、答案不对”的内容。例如,同样讨论账号管理的文档,未必回答当前产品的权限问题。因此,需要同时检查召回覆盖和结果相关性。
如果正确文档已经稳定进入候选前列,现有排序足以满足需求,就没有必要仅因架构图里常见 reranker 而增加一层。
四、用自身查询集比较质量、延迟与成本
建议先固定数据快照、切块方式、过滤规则和返回数量,再比较四组配置:关键词检索、向量检索、混合检索,以及混合检索加语义重排。若关键词召回已经足够,也可补测关键词加语义重排。
查询集应覆盖前述三类需求,并保留真实失败查询。测试查询最好来自实际使用记录;没有记录时,可以编写测试题,但应明确它们是人工构造的,不能当作真实流量分布。
评估时分开记录:
- 召回覆盖: 已标注的相关文档或片段是否进入候选集,可使用 Recall@k。需要事先明确,评估单位是文档还是切块。
- 排序质量: 正确结果出现的位置。单一目标查询可观察 MRR,多条结果有不同相关程度时可使用 nDCG@k。
- 延迟与费用: 在一致负载下记录端到端延迟,关注 p50、p95,并按实际配置核算查询、向量化、索引和重排等相关开销。
RAG 还应单独评估最终回答是否正确引用证据。检索指标改善,不自动等于回答质量提高。
最后按查询类型拆开看结果。平均分可能掩盖精确标识符查询的退步,也可能低估概念查询的改善。如果某类查询明显受益、另一类却变差,可以进一步测试查询分流,而不是默认所有请求都走同一套配置。
下一步可以从一份失败查询清单开始:逐条标注“内容缺失”“召回遗漏”“融合后掉出”“重排靠后”或“生成误用证据”。先找到损失发生的位置,再决定增加哪一层,实验才有明确的验证目标。


 直连行业大牛导师,1v1模拟面试与求职指导
 实战与求职精品课程
 2000+名企面试真题