篱笆资讯
OpenAI FDE 为何不止于 AI Demo?读懂大会预告中的工作链条
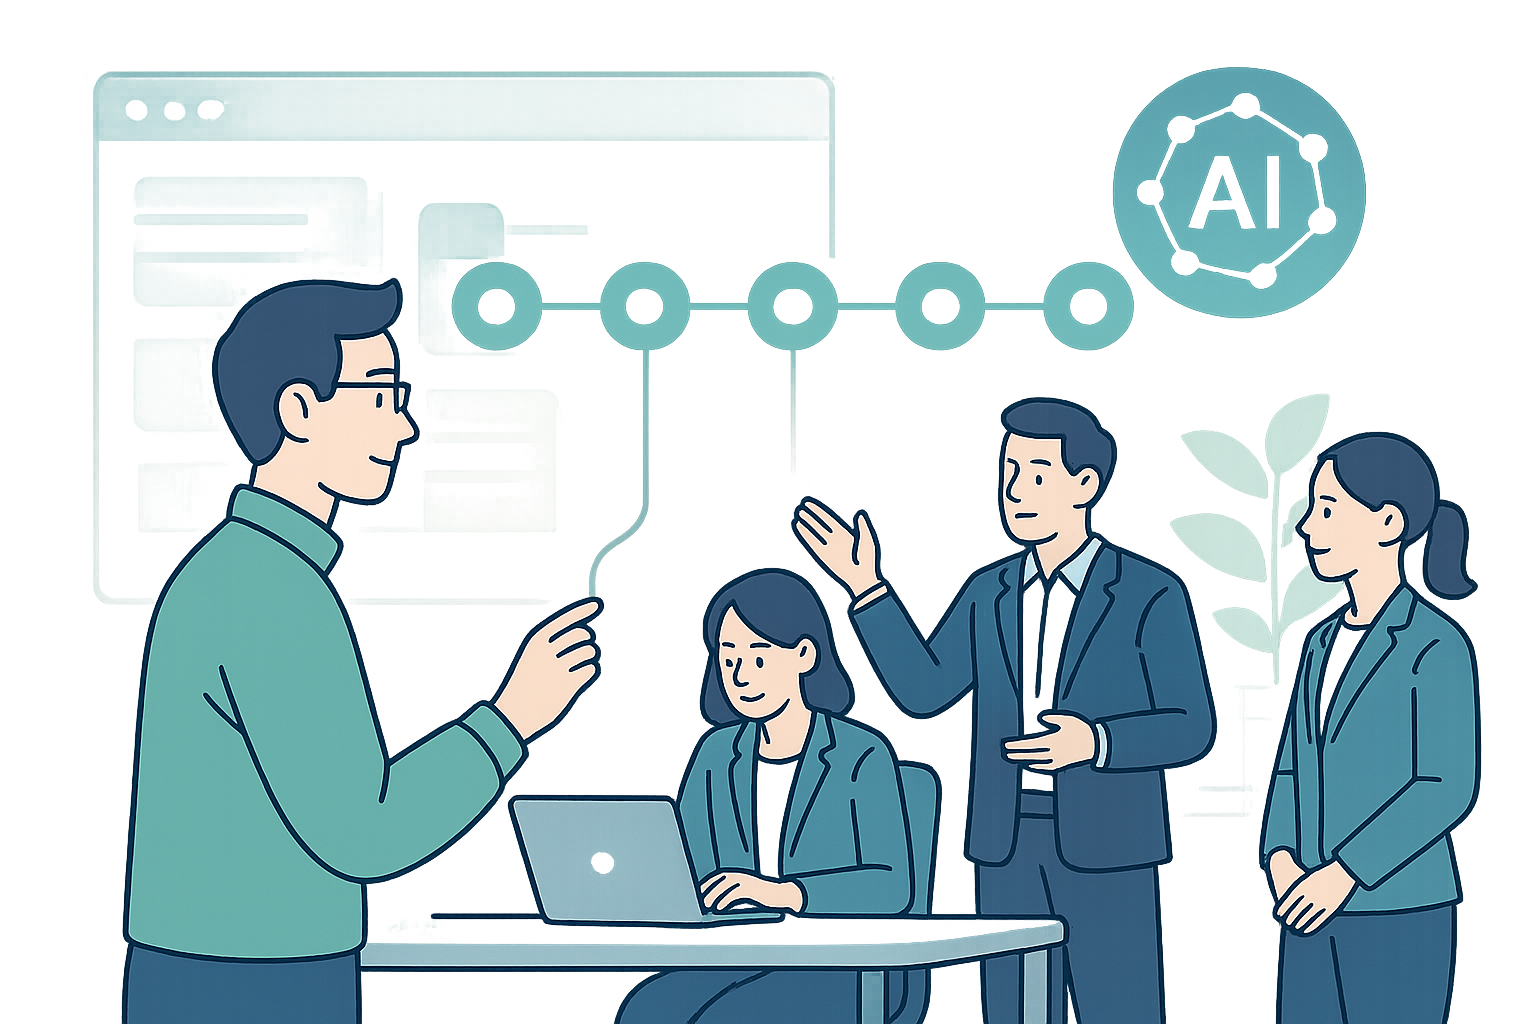
从 AI Demo 到企业工作流:拆解 OpenAI FDE 的四个环节
一次 AI Demo 可以展示模型如何回答问题、生成内容或处理一段输入。但演示成功之后,企业仍有许多问题没有得到回答:这项能力解决了什么业务问题?接入现有流程后是否可靠?出了问题由谁处理?
理解 Forward Deployed Engineering(FDE,前线部署工程)的工作内容,可以从这些问题入手。
本文以大会预告中的 FDE 职能描述为讨论范围。预告将 OpenAI FDE 描述为连接前沿模型与真实企业场景的一线团队,工作覆盖业务问题定义、原型设计、生产部署,以及向产品和模型迭代传递反馈。
这是一段大会宣传中的职能介绍,不是 OpenAI 正式岗位说明,也不是客户项目成效报告。下面解释的是这条工作链为什么需要衔接,不据此推断实际收益或所有 FDE 岗位的职责。
1. 问题定义:先确定值得解决的业务任务
1. 问题定义:先确定值得解决的业务任务
问题定义回答的是:要改善哪项任务,怎样判断改善发生了?
“做一个企业知识助手”可以成为项目名称,却还不足以指导工程实现。谁会使用它?他们目前在哪里查资料?真正耗时的是搜索、理解,还是确认资料是否仍然有效?不同答案会导向不同方案。
以一个假设的内部知识问答场景为例,这不是 OpenAI 客户案例。员工查不到答案,可能因为文档分散,也可能因为文档过时或权限不足。模型即使能流畅作答,也未必解决这些原因。
因此,在这一阶段,合理的工程讨论通常需要明确任务范围、现有处理方式和结果标准。例如,可以观察查找答案所需的时间、答案是否准确,以及是否仍需人工反复核实。这些是可考虑的评估方向,并非预告已经报告的指标。
问题定义也决定哪些任务暂时不交给系统。如果某类问题需要人工判断,方案应说明何时转交,而不是只展示成功回答。
按这条职能链理解,深入客户业务的意义在于减少方案与实际需求之间的偏差。如果目标没有说清楚,原型即使令人印象深刻,也很难证明值得继续投入。
2. 原型设计:验证最关键的不确定性
原型设计回答的是:这个方案是否值得进入下一阶段,还有什么没有验证?
Demo 是一种展示形式,原型则可以承担验证任务。两者可能使用同一套界面,区别在于如何选择测试输入、怎样解释结果。
沿用知识问答的假设场景,原型不应只挑几条容易回答的问题。还可以测试资料缺失、不同文档互相矛盾,以及提问本身含糊的情况。目的不是制造失败,而是尽早识别方案的适用边界。
一个更有用的原型评估,会记录这些信息:
- 使用了哪些材料,覆盖了哪些任务;
- 什么条件下能够得到可接受的结果;
- 失败发生在哪里,是否需要人工介入;
- 哪些结论只适用于当前测试范围。
评估还需要参照现有做法。回答速度变快了,但员工需要花更多时间核实内容,总体流程未必得到改善。反过来,系统即使不能独立完成任务,如果能稳定减少某个步骤的负担,也可能值得继续验证。
这解释了问题定义与原型之间的联系:前者规定要观察什么,后者提供初步证据。原型结果也可能要求团队重新缩小任务范围,而不是直接推进上线。
3. 生产部署:让方案接受真实工作流检验
3. 生产部署:让方案接受真实工作流检验
生产部署回答的是:真实用户持续使用时,方案能否按预期运行,发生异常后如何处理?
原型环境可以使用经过筛选的输入,安排工程师随时观察。实际工作流会出现更多变化:资料更新、权限差异、请求集中到来,用户也未必按照设计者预想的方式操作。
因此,企业 AI 部署通常还要处理系统接入、访问权限、运行监控、异常恢复和维护责任。这些是一般性的工程考虑,不能据此断言 OpenAI FDE 在每个项目中都采用相同技术或承担全部责任。
对于假设中的知识问答系统,上线前值得追问:它能否访问用户有权查看的资料?答案无法确认时怎样提示?服务不可用时,员工是否还有原来的查找路径?
其中有些问题不靠更强的模型解决。资料更新机制不完整,可能导致答案过时;权限设计不清楚,可能让系统接触不应使用的内容。企业工作流的可靠性取决于多处连接,而不只取决于某次回答的质量。
部署完成也不等于业务价值已经得到证明。如果要判断效果,还需要结合实际使用记录、原有流程和明确的评价口径。所供预告提出了验证可衡量价值的目标,但没有提供足以确认收益的项目结果。
4. 反馈迭代:把现场问题转成可行动的证据
反馈回答的是:现场暴露了什么问题,哪些值得带回产品和模型迭代?
真实使用中的失败不能全部归为“模型不够好”。一次回答错误,可能源于输入材料缺失、信息检索不准确、任务要求不清晰,也可能涉及模型的理解或推理能力。只有保留必要上下文,反馈才有诊断价值。
一条可行动的反馈,通常需要说明用户当时要完成什么、系统拿到了什么输入、预期结果是什么,以及偏差出现在哪一步。反馈还应遵守相应的数据处理要求,不能为了排查问题就随意收集或传播业务信息。
从机制上看,不同发现可能指向不同改进方向:交互不清楚,可以考虑调整产品流程;资料过时,应检查数据更新;在输入充分且任务明确时仍反复出现的能力缺口,才更值得进一步评估模型表现。
这是一般性的诊断思路,不是 OpenAI 内部团队分工的说明。预告并未交代具体问题由哪个团队负责,也没有证明一线反馈已经带来了哪些改进。
反馈之所以要接回前面的环节,是因为现场发现可能改变最初的判断。某项任务需要更多人工审核,原型就应重新测试;业务目标发生变化,问题定义也要更新。这条链未必是走完一次就结束的交付顺序。
对在美国探索相关岗位的开发者和产品人员,这段描述最有用的地方,是提供了一组阅读职位说明(JD)的具体问题:
- 岗位是否参与业务问题定义,还是接收已经确定的需求?
- 原型的评价标准是什么,谁决定是否继续推进?
- 部署后需要承担哪些运行与维护责任?
- 现场反馈如何进入后续改进?
这些问题可以帮助你辨认工作重心,但不能把大会预告直接转成任职要求。按本文讨论的描述,FDE 不止于制作 AI Demo,是因为展示模型能力只回答了链条中的一部分问题。业务目标、验证证据、运行条件与反馈机制接得上,才能进一步讨论模型在真实企业流程中是否有用。


 直连行业大牛导师,1v1模拟面试与求职指导
 实战与求职精品课程
 2000+名企面试真题