篱笆资讯
AI 应用成本评估:合格任务成本与分流策略
AI 应用成本别只看 token 单价
做 AI 项目选型时,模型报价表很容易成为比较起点。但输入、输出 token 的价格,不能直接回答一个问题:交付一个可用结果,到底要花多少钱?
低价模型可能需要更多上下文、多轮调用或人工修正。本地部署没有同样形式的 API 账单,却有设备、运维和闲置算力成本。按任务分流,也会增加判断、监控与升级调用的开销。
来源文章提出了从 token 报价转向结果成本的视角,其依据属于会议观察与作者判断。下文提供的是核算和评估框架,不是已验证的降本方案。对课程项目、AI 应用开发或技术产品选型,更有用的起点是先确定什么算“完成”。
一、先定义合格任务,再确定费用边界
一、先定义合格任务,再确定费用边界
一次模型调用,不一定对应一个完成的任务。生成 SQL 后还要运行检查,提取合同字段后可能需要核验,生成客服回复后也可能转人工。
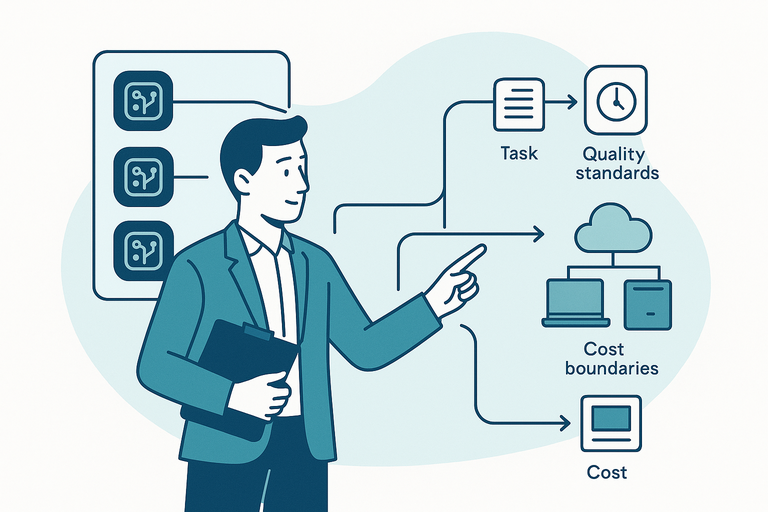
因此,比较方案前要写清三个条件:
- 任务单位是什么? 例如处理一份文档,而不是每次 API 请求。
- 什么结果算达标? 例如关键字段准确、引用可追溯、输出格式有效。
- 有哪些交付限制? 包括响应时间、允许的人工介入,以及数据能否发往外部服务。
验收标准要能执行。“回答质量不错”无法稳定计数;字段校验、自动化测试和按固定规则进行的人工复核,更适合形成可比较的结果。
费用边界也应提前确定:
| 费用类别 | 应纳入的内容 |
|---|---|
| 模型调用 | 实际输入、输出及服务账单中的其他计费项 |
| 重试与升级 | 失败后重跑、改用其他模型的调用费用 |
| 周边服务 | 检索、存储、工具执行与路由判断 |
| 本地算力 | 设备折旧或租赁、电力、运维及共享资源分摊 |
| 质量保障 | 按统一口径计入的评测、监控与人工复核 |
重试费用已经包含在调用账单中时,不要再加一次。共享服务器也不能把整台机器的费用分别算给每个项目,应记录分摊依据。
一次性部署投入与持续运行费用最好分列。比较两个方案时,统一统计周期、币种和费用范围。美国项目可以统一按美元记录,但不要拿一个方案的完整运行成本,与另一个方案的 API 账单直接比较。
二、用“总费用÷达标任务数”看交付效率
在相同任务集和验收标准下,可以使用:
单位合格任务成本 = 该批任务相关总费用 ÷ 达标任务数
分子包含失败任务消耗的资源,分母只计算最终通过验收的任务。同一个任务重试多次后成功,只计一个达标结果。如果没有任务达标,这个指标无法给出有效的单位成本,应先解决质量问题。
这个口径解释了为什么低报价不一定带来低成本:一个方案总费用更低,但达标数量下降得更多,交付每个合格结果反而可能更贵。
大模型 token 价格仍然重要,只是需要结合实际用量。同一任务在不同模型下,提示词长度、输出长度和调用次数未必一致。比较单价之前,应先检查这些差异。
本地大模型成本则特别依赖利用率。设备在统计周期内的固定费用,需要分摊到实际承载的工作量中。任务量少、空闲时间长时,即使单次推理看起来便宜,平均交付成本也可能偏高。
建议同时保留三个指标:
- 单位合格任务成本,用来判断经济性。
- 达标率,用来判断交付可靠性。
- 响应时间分布,用来发现升级调用造成的等待。
若结果依赖人工修正才能达标,人工时间必须计入,并将“自动完成”和“人工辅助完成”分开报告。否则,表面上的低成本可能只是把工作转移给了审核人员。
三、任务分流改变了资源匹配,也增加了系统开销
三、任务分流改变了资源匹配,也增加了系统开销
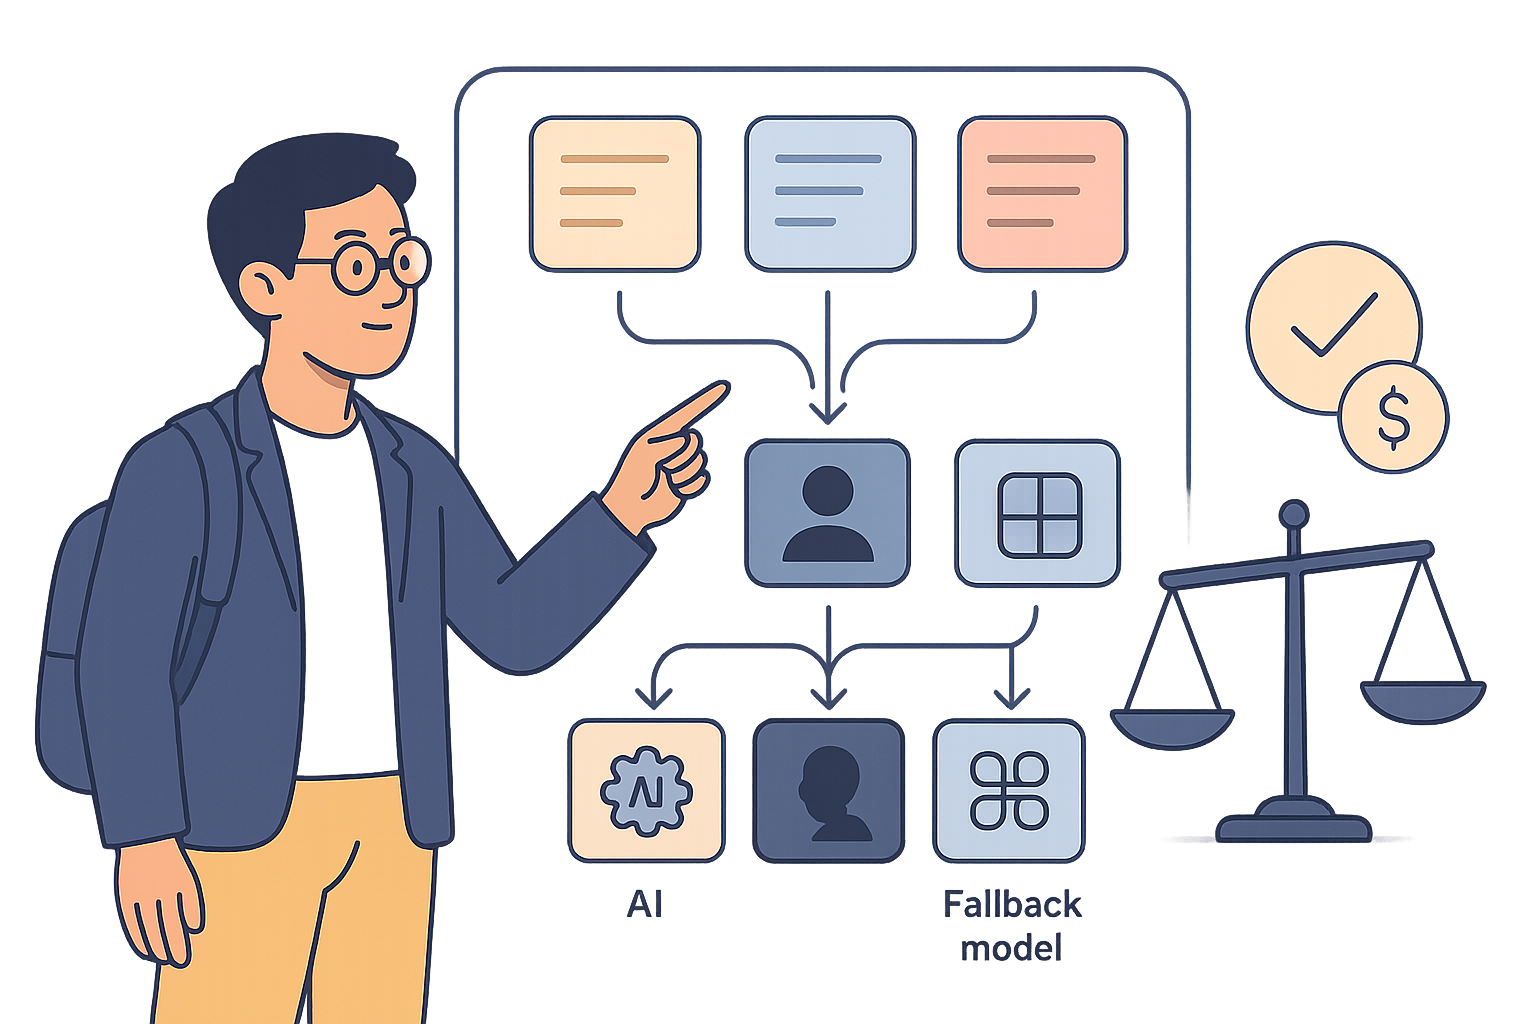
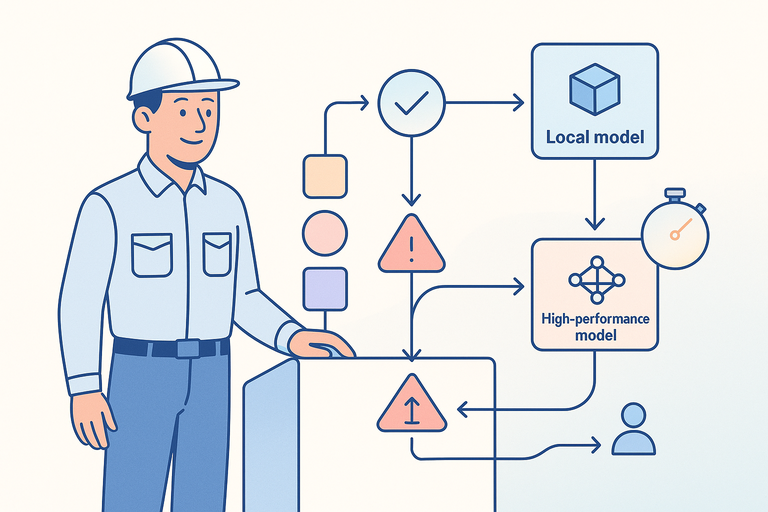
任务路由的基本思路,是根据任务特征选择处理资源,而不让所有请求使用同一种模型。
例如,格式稳定、验收规则明确的任务,可以测试由本地模型处理;需要更强推理能力的任务,可以测试交给前沿模型。但这只是候选设计。任务短不代表容易,本地运行也不代表一定满足质量、延迟或数据要求。
一种可评估的流程是:
- 根据输入特征和业务规则选择初始模型。
- 执行任务,并用字段检查、测试结果或人工复核验证输出。
- 未达标时,升级到另一模型或转人工。
- 记录全过程的费用、耗时和最终结果。
不要只凭模型自报的“信心”决定是否升级。能直接检验交付质量的规则,通常更适合作为分流依据;难以自动验收的任务,则需要保留人工评估。
分流本身也会花钱。路由器可能调用模型,验证器需要资源,先尝试本地再升级会支付两段处理成本。若大量请求最终都要升级,前置步骤可能增加费用和延迟。
来源文章中的分流比例只能理解为其观察中的描述,不能成为通用配置。逐年降本也应保留为待验证观点。具体效果取决于工作负载、模型能力、利用率和验收标准,不能仅凭架构名称推断。
四、用同一测试集决定是否上线
评估前,先保留一个简单基线,例如全部任务交给同一模型。否则,即使分流方案看起来有效,也无法判断新增复杂度是否值得。
可以按以下步骤执行:
- 整理任务集。 纳入常见任务、复杂任务和失败边界,保留独立测试集,避免只在调参用过的数据上评估。
- 统一验收。 所有方案使用相同质量门槛和人工复核规则,不因某个方案便宜就放宽标准。
- 记录完整路径。 保存各阶段 token 用量、调用次数、重试、升级、耗时及人工介入。
- 分别测试成本与负载。 先比较同一批任务,再检查不同任务量和并发下的本地利用率、排队与稳定性。
- 设定上线条件。 只有在质量满足要求、单位合格任务成本改善且响应时间可接受时,才扩大使用范围。
结果最好整理成一张表,而不是只展示节省比例:
| 方案 | 总费用 | 达标率 | 合格任务成本 | 响应时间 | 人工介入 |
|---|---|---|---|---|---|
| 单模型基线 | 实测 | 实测 | 按公式计算 | 实测分布 | 实测 |
| 本地处理方案 | 含算力分摊 | 实测 | 按公式计算 | 实测分布 | 实测 |
| 分流方案 | 含判断与升级 | 实测 | 按公式计算 | 实测分布 | 实测 |
对于准备技术项目或求职作品的学生,这样的评估记录也比“用了更便宜的模型”更有说服力:它展示了质量标准、成本边界和技术取舍。
下一步可以先选一个边界清楚、能验证结果的任务,跑出单模型基线,再增加一个分流方案。如果达标率下降,或大量任务必须升级,就先修正设计,不急着扩大部署。真正需要比较的是可重复交付的成本,而不是报价表上最低的数字。


 直连行业大牛导师,1v1模拟面试与求职指导
 实战与求职精品课程
 2000+名企面试真题