篱笆资讯
结构化输出能消除幻觉吗?分清类型安全、校准与判断正确
结构化输出不等于判断正确:类型安全与置信度的边界
模型返回了合法 JSON,分类值落在预设选项内,还附上了 `0.8` 的置信度。这样的结果更容易被程序处理,但仍不足以证明答案正确。
围绕 Jev 的讨论,可以提炼出一个待检验的推论:如果模型只能从预定义选项中作答,是否就能排除幻觉?本文只分析这一推论,不评价 Jev 的具体实现、校准水平或实际准确率。
评估 AI 应用时,需要分别检查:输出是否合规,置信度是否经过验证,以及当前判断是否有证据支持。它们不能相互替代。
一、类型约束能拦住非法输出,拦不住错误选项
一、类型约束能拦住非法输出,拦不住错误选项
这里所说的“类型安全”,限定为输出符合约定的类型、字段和取值范围,不延伸讨论编程语言中的完整类型系统。
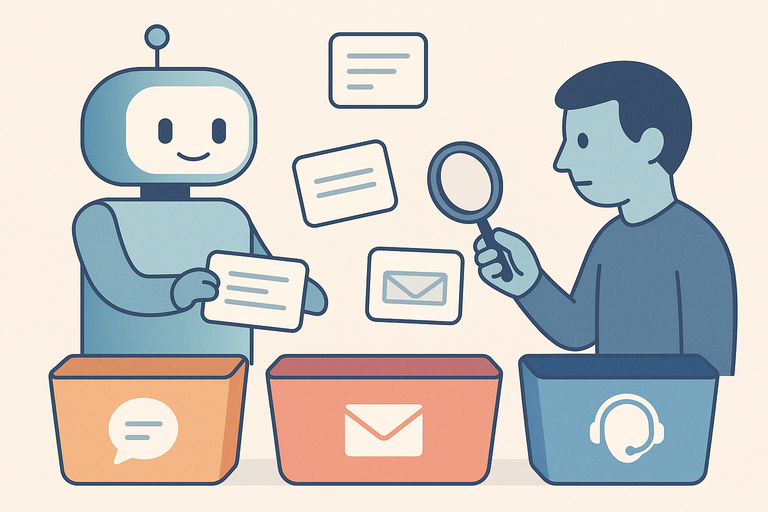
假设你设计了一个消息分类器,只允许返回以下三种标签:
- `billing`:账单问题
- `technical`:技术故障
- `other`:其他问题
用户说“发票金额不对”,模型却返回 `technical`。这个标签完全合法,也可能顺利通过校验,但分类仍然错误。
选中了错误的合法选项,是类型约束无法独自解决的问题。
| 检查层次 | 可以检查什么 | 不能据此证明什么 |
|---|---|---|
| JSON 语法 | 结果能否解析 | 字段内容是否真实 |
| 类型与取值约束 | 字段类型、枚举值、数值范围是否合规 | 分类是否符合输入 |
| 语义核验 | 结论是否有证据支持、是否符合任务规则 | 所有未来输入都不会出错 |
而且,“要求模型按格式回答”与“系统确实强制约束输出”也不同。提示词只是提出要求;解析器可以发现并拒绝非法结果;受约束生成则在生成过程中限制可选内容。具体保证到哪一步,需要查看实现和测试,不能只看一个成功示例。
预设选项是否覆盖真实情况同样重要。如果任务允许答案只有“通过”和“不通过”,但输入缺少关键材料,模型可能被迫二选一。此时即便返回值合法,也掩盖了证据不足。
因此,讨论类型安全与模型准确率时,应把“通过格式校验”单独记录,不能直接算作“任务完成正确”。
二、有置信度数值,不代表概率已经校准
概率校准关心的是:模型表达的把握,是否与一组预测的实际正确比例相符。
看一个纯假设示例,不是任何产品的实测结果:
某分类器对 100 条消息都给出 80% 的置信度。如果其中 80 条分类正确,那么这组结果与“80% 把握”的表达相符。如果只有 50 条正确,模型在这组样本上就表现得过于自信。
这并不意味着每次给出 80% 都会正确。即使该组完全符合这个比例,仍有 20 条错误。对于某一条消息,仅凭分数无法知道它属于正确的 80 条,还是错误的 20 条。
还要先问清楚,置信度指向什么事件:
- 是“所选类别正确”的概率?
- 是答案中某个事实成立的概率?
- 还是模型生成的一句自我评价?
这些数值不能混用。模型说“我有 80% 的把握”,本身只是输出了一段内容;即使系统提供 token 概率,也不能未经验证就把它等同于整个答案正确的概率。
实际评估通常会把相近分数分组,对照每组的平均置信度与实际准确率,再画出可靠性图。样本量、分组方式和标签质量都会影响判断。只展示几个答对的高分案例,不足以证明校准良好。
校准也有适用范围。在某个测试集上表现不错,不代表换成更专业的问题、另一种语言或新的用户群后仍然成立。总体结果还可能掩盖某类输入上的过度自信。
三、群体统计成立,也不能免除单次核验
三、群体统计成立,也不能免除单次核验
准确率与校准回答的是不同问题。一个分类器可能经常选对,却系统性地高估把握;另一个分类器可能正确率较低,但对自身不确定性的表达相对诚实。
即使整体准确率较高、校准表现也不错,单次判断仍可能出错。尤其在付款审批、访问权限或其他错误成本较高的流程里,能否自动执行,还取决于业务容错程度和核验机制。
讨论结构化输出与幻觉时,还应区分三种错误:
| 错误类型 | 示例 | 主要核验方式 |
|---|---|---|
| 格式错误 | 应返回对象,却返回了字符串 | 解析、类型和字段校验 |
| 错误分类 | 将账单投诉标为技术故障 | 对照标签、规则和输入证据 |
| 事实编造 | 引用了实际不存在的手册条款 | 检查原始文档与引用位置 |
错误分类不必一概称为“幻觉”。同样,合法 JSON 也可以装着虚构的条款编号或不存在的来源。
有限选项能够压缩自由编造内容的空间。如果选项本身已经核实,模型也无法凭空创造一个新选项。但它仍可能选择不适用于当前输入的选项。
所以,“不能输出非法内容”不能单独推出“不会作出错误判断”。 核验时应检查证据是否支持结论,而不只是确认结果能被程序读取。
四、把三个条件拆成一份评估记录
对开发者和技术产品人员而言,下一步是把不同保证分别测试,而不是继续增加一个看起来更精确的分数。
可以按以下顺序开展评估:
- 先定义任务与正确标准。
写清每个类别的含义、边界和证据要求。对材料不足、类别重叠、超出任务范围的输入,明确是否允许返回“无法判断”,避免强制选择掩盖问题。
- 分开记录格式与任务表现。
格式合规率回答“系统能否接收输出”,准确率或分类指标回答“任务是否做对”。检查错误集中在哪些类别,并保留失败样本。不要把校验失败的结果悄悄删掉后,只汇报剩余样本的准确率。
- 用独立数据检验置信度。
如果进行了校准拟合,不应只在同一批数据上宣布效果。用独立评估数据对照预测分数与实际结果,记录样本量和分组方法,并检查重要输入类别。高置信度但错误的样本尤其值得复查。
- 根据错误成本设置处理路径。
区分自动处理、人工复核和拒绝作答。阈值应根据验证结果与业务损失确定,而不是因为某个分数“看起来够高”。允许拒答时,还应同时报告自动处理的覆盖率与这部分结果的错误率。
最终的评估记录至少要写清:数据来源、任务定义、约束方式、指标、失败样本和适用范围。如果缺少带标签的验证数据,应如实说明“尚未验证校准”,不要把置信度当成现成的质量证明。
若你准备在美国的 AI Engineer 或 Machine Learning Engineer 岗位面试中介绍这个项目,可以用这份记录解释设计取舍:哪些错误由结构约束拦截,哪些需要统计评估,哪些仍交给人工核验。
比起展示一段漂亮的 JSON,这更能说明你理解系统的可靠性边界,也知道下一轮测试该解决什么问题。


 直连行业大牛导师,1v1模拟面试与求职指导
 实战与求职精品课程
 2000+名企面试真题